前段时间给一些甲方品牌和乙方上ai课,有点疲了。
聊的话题多跟营销、内容、提案为主,业务上:围绕多模态内容控制、内容自动化生产为主。
大家目前最关心的事情: 控制:怎么让 AI 生产出我的品牌需要的东西?
今天让 AI 写一段话、出一张图、生成一段视频,已经很容易了。
难的是:能不能用?符合品牌调性?这次做对了,下次能不能继续做对?
持续的可控性,成为大家关心的终点。
新工具、新模型,能替你解决品牌内容吗
每次有新模型、新工具出来,市场都会重新兴奋一次。
很多人心里有一个预期:模型再进化一轮,工具再强一点,品牌内容这些日常业务里的卡点,就会被它顺手解决掉。
2026 年上半年,头部模型最明显的竞赛集中在 coding、Agent、工具插件化这几条线上。这些方向的能力确实在快速拉升。
但回到我们的业务现场,体感是这样的:品牌文字、内容生产这一块,"AI 味反而更重了"——模型能写,写出来却不像这个品牌该说的话。品牌适配性,并没有随着 coding 能力的暴涨被自动捎带解决。
一部分是ai的偏科问题,一部分是我们自己对于ai的应用问题。
经常能听到有人笼统地说一句"这个东西生成得不行"。
但同样的输出,我们目前看一眼,需要继续往下定位:是任务给得太笼统、参考样稿给错了方向,还是漏掉了一个会影响结果的关键维度。
把这些点找准、定向改一遍,结果通常会明显改善。
当生成不成问题,真正拉开差距的点就变成了 看到问题 定位问题 解决问题。
一个人连问题在哪都看不见,或者连目标和判断标准都没想清楚,换再强的模型也没用——上限再高,也没法替使用者补上判断力。
今天主要跟大家分享下 我对于多模态控制的一些理解。
文字:你怎样描述,它就怎样收窄答案
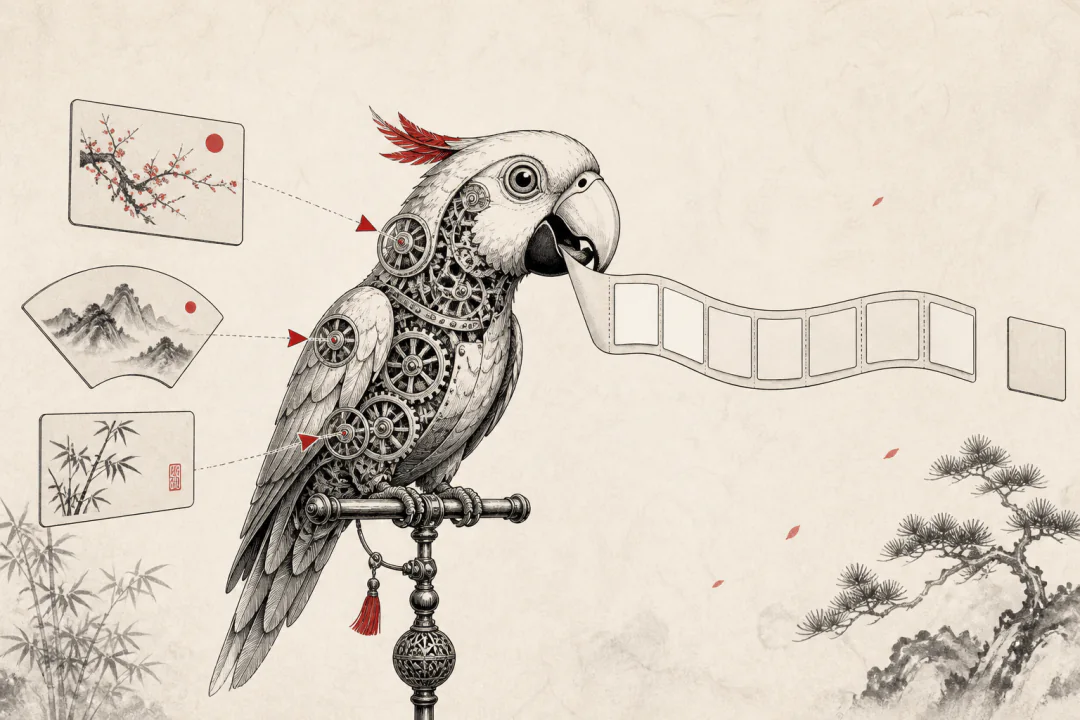
可以把文字模型理解成一只"赛博鹦鹉"。
它读过海量文字,看着已经出现的内容,根据学到的概率关系,一次吐出下一个字词片段,然后不断接下去。给它什么上下文、参考和要求,会影响它接下来怎样说。
实际操作时,先要有几个基本认知。
- 不同模型有不同的默认风格和能力边界;目前文字感受上比较好的模型(deepseek的v3.2 、claude-opus-4.6、… )
- 好内容需要把你的业务 know-how 交给模型;通过蒸馏、提炼、口述都可以。
- "AI 味重"有几个核心特征:
- “不是……而是”
- 过度使用逻辑连接词:“首先、其次、最后、值得注意的是、更重要的是”;
- 过度完整,什么都想说,不停换一种方式重复同一个意思;
- 喜欢写一些莫名的科学术语:拓扑、坍缩、量子纠缠;
基于每次的生产,笼统地给一个“ai味过重”,ai会懵:噢噢噢噢噢噢噢噢那我改。
但很难改到位。
你需要继续往下拆:是连接词太多,还是说话太空?是总在重复同一个意思,还是每一段都完整得像一份说明书?
从品牌的角度而言,一个有效的起点是:把品牌过去被验证过的好内容,按语言、结构、叙事、情绪、节奏等维度做一次蒸馏。
最终交给模型的,是具体描述、正反例和评价标准——不只是一句"像我们品牌一点"。
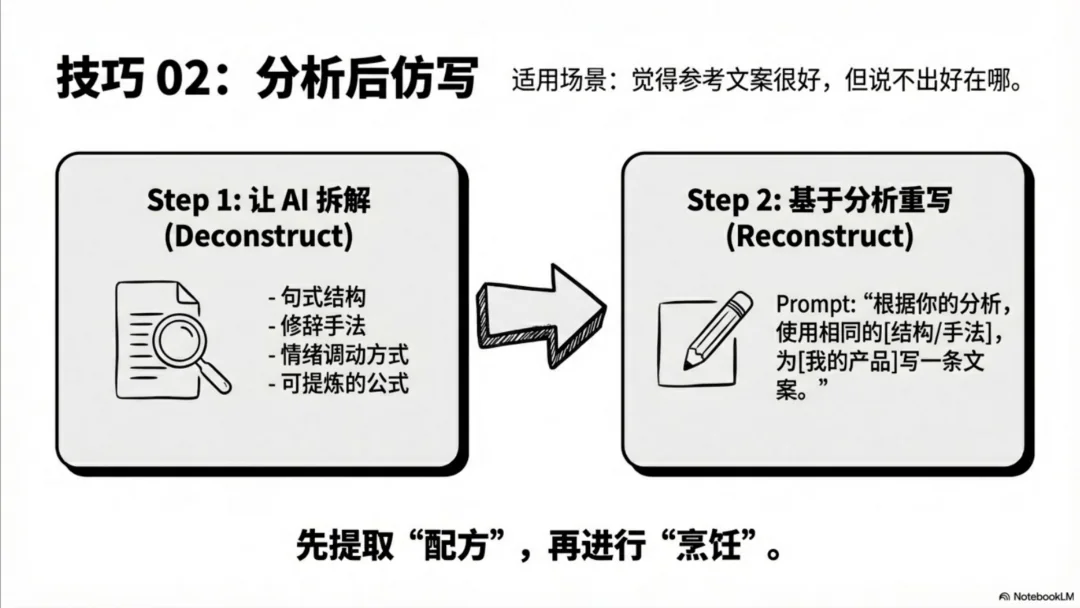
下面两段 Prompt,很适合说明"描述"怎样变成"控制"。
第一段是我们常用来生成诗性的 TVC 创意的词:
锚定具象: 选择一个看似普通却蕴含多重可能性的具体事物作为诗歌的锚点。这个事物可以是日常的物品、自然景象,甚至是某种状态。
多维感知与解构: 从视觉、触觉、听觉、甚至味觉等多个感官维度去细致地观察和体验这个锚定物。并尝试解构它,思考它的组成部分、运行机制、生命周期、与周围环境的关系等等。
情感投射与关联: 将自身的情感、体验、困惑、渴望等投射到这个锚定物上。思考这个事物如何与自己的内心状态产生共鸣,它象征着什么,代表着什么,又指向什么。
意象流动与转接: 不要局限于锚定物本身,尝试从它出发,联想到其他相关的或看似不相关的意象。建立起意象之间的流动性和转接关系,形成一种独特的意象逻辑。这种逻辑可以是非线性的、跳跃的,但需要保持内在的情感连贯性。
挖掘悖论与张力: 寻找锚定物以及相关意象中存在的悖论、矛盾、张力。这种内在的冲突往往能深化诗歌的内涵,体现复杂的情感和思考。
赋予哲理意味: 在具象的描绘和情感的抒发中,尝试融入对生命、存在、意义等抽象概念的思考。但这种哲理意味应该是由具体的意象自然流露出来的,而非直接的理论阐述。
保持开放性与余味: 避免对诗歌的主题进行明确的解释和定义,保持诗歌的开放性,让读者有自由解读的空间。留下含蓄的余味,引发读者的思考和共鸣。
锚定具象决定创意从哪里开始,多维感知控制细节,情感投射负责共鸣,意象转接安排画面如何流动,悖论产生张力,开放性决定结尾的余味。描述越具体,模型能够游走的范围就越清楚。
虽然产出物离可直接拍摄的脚本还有一段距离,但很适合做诗性 TVC 的创意发生器。
再看一段 slogan Prompt:
角色:苹果御用文案师
"苹果公司的专业文案创作者"
技能:精准、修辞、创意
信念:极简主义、优雅、价值
表达:简练、韵律、矛盾往返能力:苹果文案
"生成 Apple 味道的产品广告文案"
处理:分析价值点 → Repetition → Contradiction → Rhyme → short → simple
few-shots:
"开新的,超开心"
"重磅实力,轻松入手"
"智能加成,超加实力"
"磅礴的薄"
"好轻新"
"为创意一画天开"
"强出天际的芯"
角色控制说话视角,信念决定价值取舍,简练、韵律和矛盾限定句式,short 和 simple 控制长度,few-shots 直接告诉模型什么样的结果算对。它最后更容易产出短、易念、有反差或双关的 slogan。
不过,"Apple 味"仍然是一个粗粒度的风格参照。品牌长期使用时,要把它换成自己的品牌人格、历史语料、正反例、禁用词和评价量表。
当我们蒸馏了自身的特性,提炼成自然语言/lisp格式的提示词,才能从一次生成走向稳定控制。
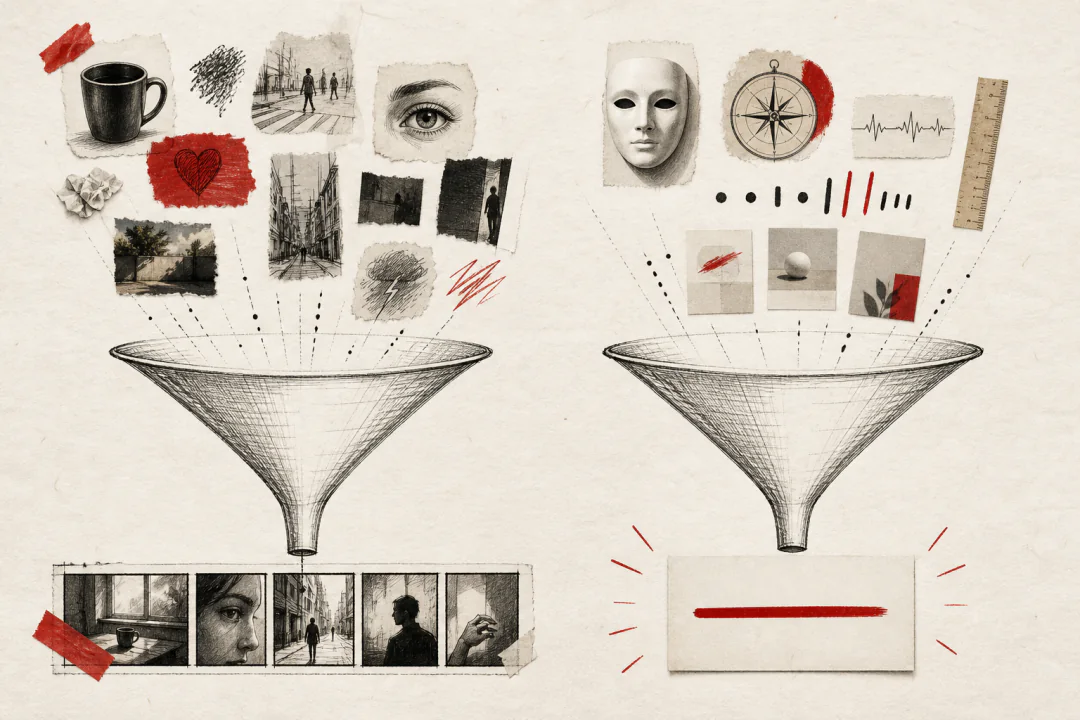
图片:AI是一个技术水平高超的美工。
可以把图片模型想成一个看过海量画面的画师。你把文字、参考图和其他条件交给它,它在这些条件里生成一张新画面。
这个过程躲不开抽卡,模型能力决定抽卡的上限。所以第一步,是选对模型。不同模型在材质还原、创意表达、人物一致性上各有强弱,先搞清楚手上的牌是什么。
但更关键的问题在这里:并不是 AI 生成不了好素材,也不是 AI 难以被精确控制,而是我们很难用语言描绘美。
"高级感""有品牌调性""画面更美"——这些说法模型听不懂。
它能接收的是:主体、构图、拍摄角度、材质、色彩、光线、背景。你能把想要的东西拆成这些因素,才算给了它真正的输入。
而且,不同类型的图,关键变量完全不同。产品图在意材质和拍摄质感;品牌海报在意创意、构图和表达;人物写真要锁的是角度、光线和人物一致性。
用同一套评价方式控制不同类型的图,本身就是控制失效的起点。
怎么控制
最常用的方法是垫图加拼图。
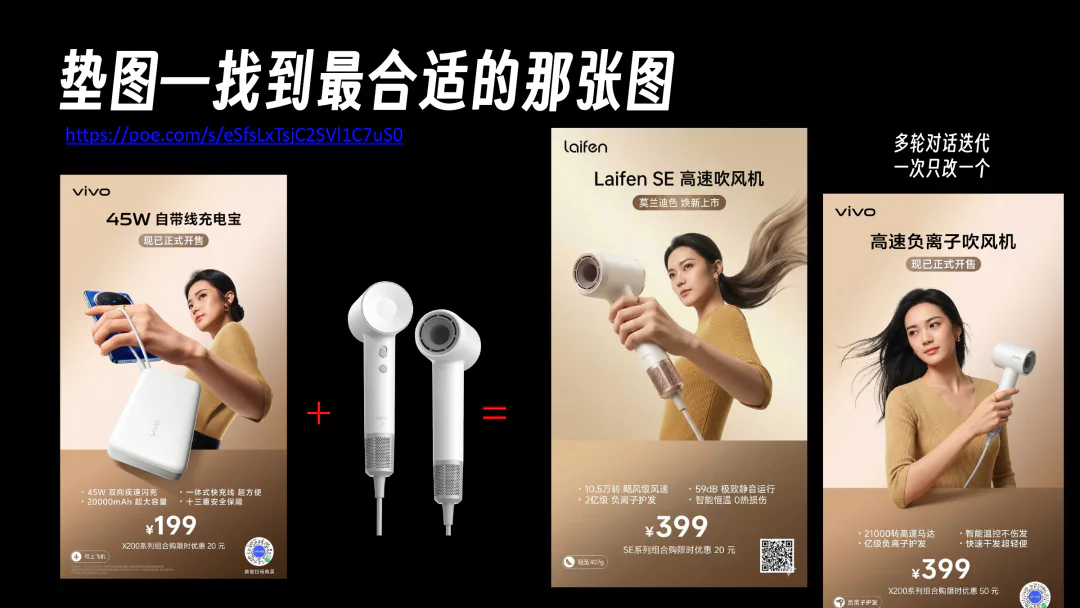
1. 垫图,不只是"上传一张参考",而是先找到离目标最近的视觉起点,再通过多轮改版逐步靠近。每次只改一个变量——这样你才能判断是哪个因素让结果变好或变坏。
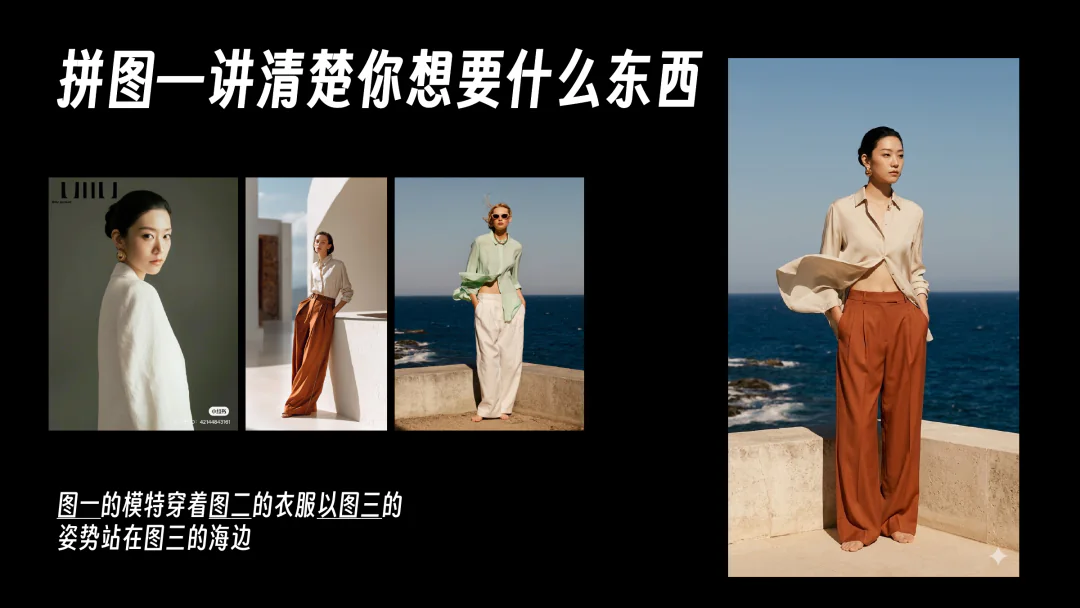
2. 拼图是给每张参考图分配明确的职责。比如要生成一张户外广告图:图一负责人物,图二负责服装,图三负责姿势和场景。
提示词可以直接说:"图一的模特穿着图二的衣服,以图三的姿势站在图三的海边。"
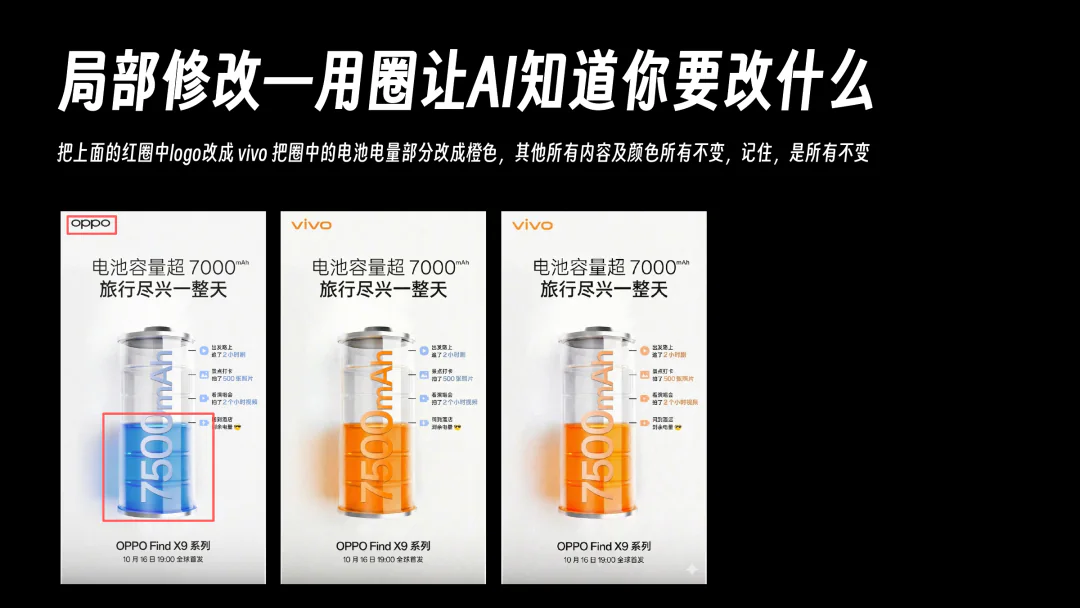
3. 如果某个局部不对,圈出来改,同时说清楚哪些内容不能动。"把圈中的电池电量改成橙色,其他所有内容及颜色不变。"这种指令的有效性,来自边界被定义清楚了。
4. 一张图的因素越少,越能还原你想要的图。甚至一张很粗糙的灰块草图也有用——先用灰块画出人物、产品和标题区的位置,再用它做构图参考。一张灰块图,往往比一大段形容词更直接。
更进一步:反推和沉淀
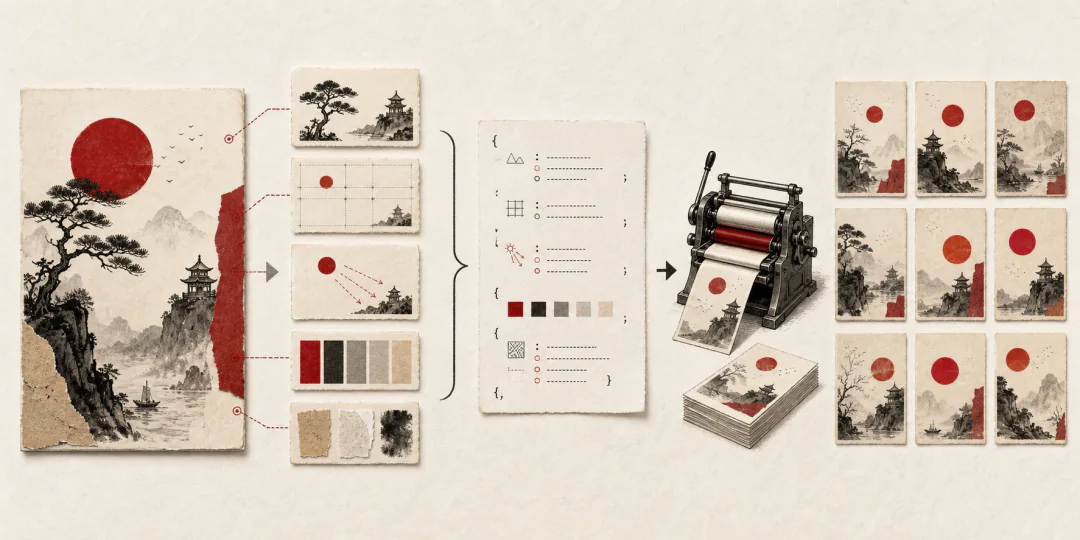
对于已经生成效果好的图,可以让模型反推提示词,把它拆成主体、构图、光线、色彩、材质等维度,用 JSON 格式记录下来。
下次想要类似效果,不用再从零摸索。
这套东西跑通之后,做电商详情页、品牌物料这类批量任务就有了基础。不再是一张一张抽,而是在一套稳定规则里批量出图。
视频:复杂项目需要工程化控制
视频相当于让前面那个画师沿着时间连续作画,每一段还要接得上。它比单张图多了动作、运镜、节奏和连续性,随机性也会被放大。
生成当然重要。但要稳定交付一条 TVC,正常广告公司会做的前期和制片流程,一步都少不了。
具体生产的部分有很多细节,因为团队分工的问题,我操作的比较少,就不絮叨了,简单说一下我们内部的操作:
一条相对完整的生产链大概是这样:
- Brief:
- 先锁定品牌调性、受众、核心卖点和情绪定位。
- 故事、脚本和分镜:
- 完整讲清故事,再决定镜头数量,为每个镜头标出构图、时长和运镜。
- 一致性资产:
- 准备主角的正面、半侧面和侧面参考,加上 moodboard 和产品图,先锁住人物、产品和整体气质。
- 静态分镜:
- 逐个生成画面,提示词负责主体、场景、光线和构图;每一帧通过评审后再继续。
- 动态镜头:
- 把通过的静态分镜转为视频,这一轮只补动作和运镜,尽量不覆盖画面里已经锁定的信息。
- 后期交付:
- 完成口型、配音、BGM、剪辑、调色和最终版本。
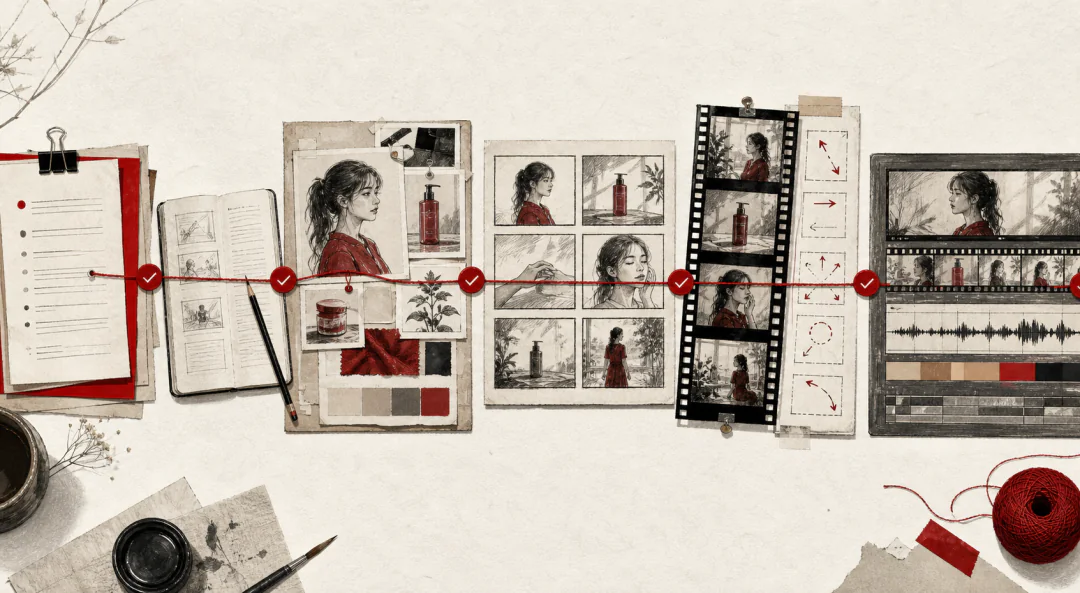
首尾帧和故事板,都要放在这条链路里理解。
比如一支 5 秒饮料广告,首帧像第一颗钉子,锁定冰面上的完整产品;尾帧像第二颗钉子,锁定瓶盖弹开、水珠飞溅和品牌露出;文字只补中间的镜头推进和动作节点。两张图提高了起点和终点的可控性,中间过程仍然由模型生成。
一支 15 秒新品片,可以先拆成六格:材质特写、产品全貌、人物使用、功能结果、生活场景、产品与 slogan 落版。
每一格或相邻两格分别生成短镜头,哪一段失控就只重做那一段,最后再在时间线上裁切、排列和组装。
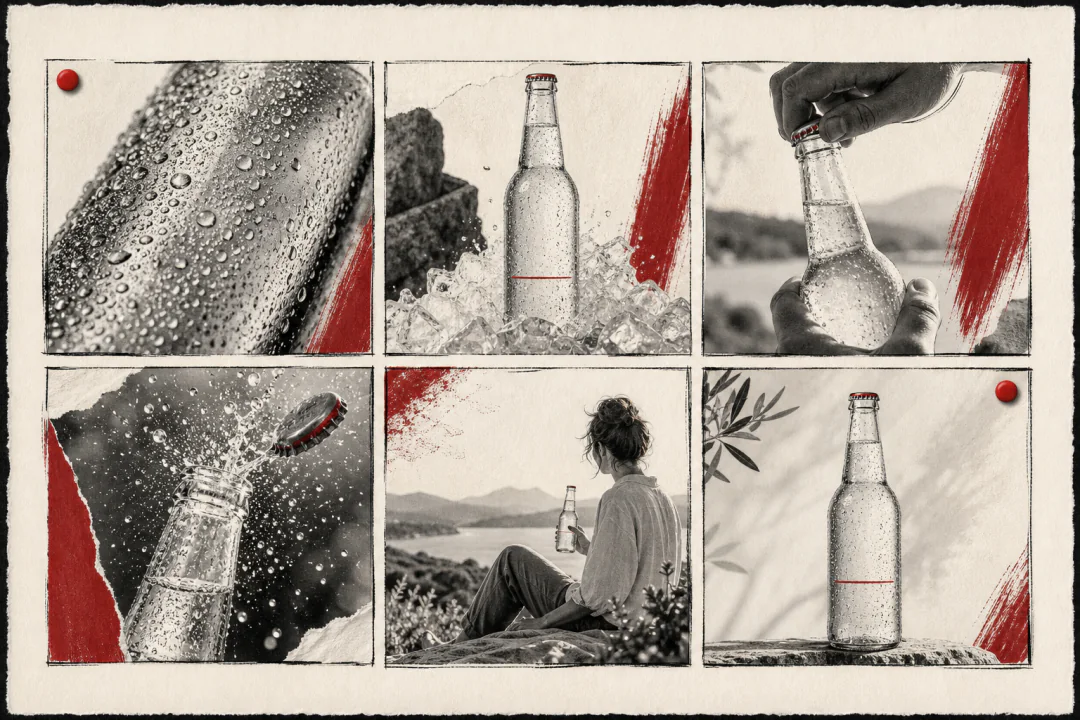
这套方法做的一件事:把抽卡变成工程。不再靠运气碰到一条能用的,而是把前期规范、中间评审和分段控制叠加起来,让结果可以复现。
缺少规范、资产、流程和评审,团队很容易陷入无限抽卡:今天运气好,抽到一条能用的;明天怎样复现,没人知道。
复杂项目的控制,从来都不只发生在生成按钮按下去的那一刻。前期规范、资产准备、镜头拆分、中间评审和后期组装,加起来才是完整的生产控制。
控制能力,是在修改中长出来的
AI 生产很少一次完成。
真正有用的东西,是在改的过程里沉淀下来的:这个提示词有效,保留;那个参考图方向不对,换掉;这种评审方式让结果稳定,固化成流程。
这就是为什么说"长出来",而不是"学出来"。控制能力不是读完一套方法论就有的,它要附着在具体的品牌、具体的业务、具体的反复改版上,才会生长。
别人的方法可以参考,但最终稳定下来的结构,我们需要 get-hands dirty。
慢慢地,品牌会积累自己的参考素材、提示词、正反例、评价标准、制作流程和评审方式。这些东西组合在一起,才是真正意义上的生产能力。
营销人学 AI,最该抓住两条主线
最后再讲一下学习。
到了今天,营销人的 AI 学习路线也很清晰:
- 一条是 Agent 的使用和自动化构建——解决怎样把任务组织起来、让工作持续推进。
- 一条是控制好文字、图片和视频的生产——决定最终交付的东西能不能用进业务。
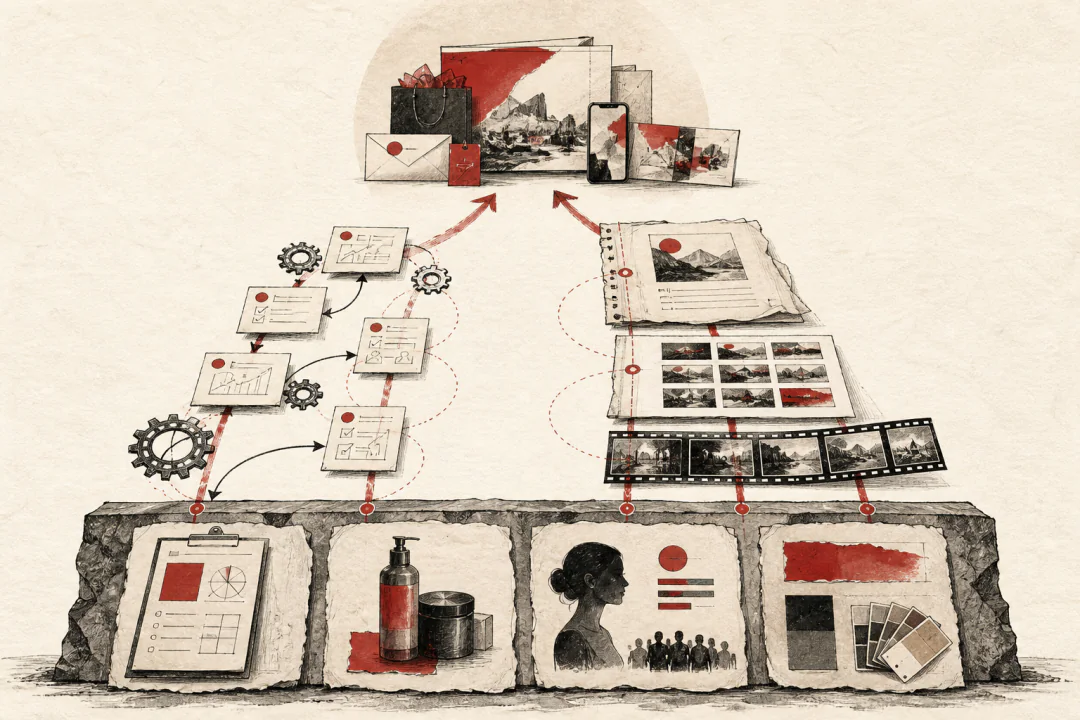
但这两条线本身,也会随着工具迭代继续变化。不变的,是一个更底层的判断:AI 在我的业务里能做什么,边界在哪,怎样持续创造价值。
不要从工具出发,要从自己的业务出发。
就聊到这。